UBS: Hot Chips 2026 模型规模 + KV 缓存持续增长。路线图现在聚焦于容量、带宽和扩展——而非峰值 FLOPS GOOG TPU 8i(推理
- 序号:046
- 星球链接:打开网页
- 附件:图片 4,音频 0,文档 0
- 音频文件:无音频
图片
4848281854111448
2858481825111851
1525158542888412
5121418152888414
正文
UBS: Hot Chips 2026
模型规模 + KV 缓存持续增长。路线图现在聚焦于容量、带宽和扩展——而非峰值 FLOPS
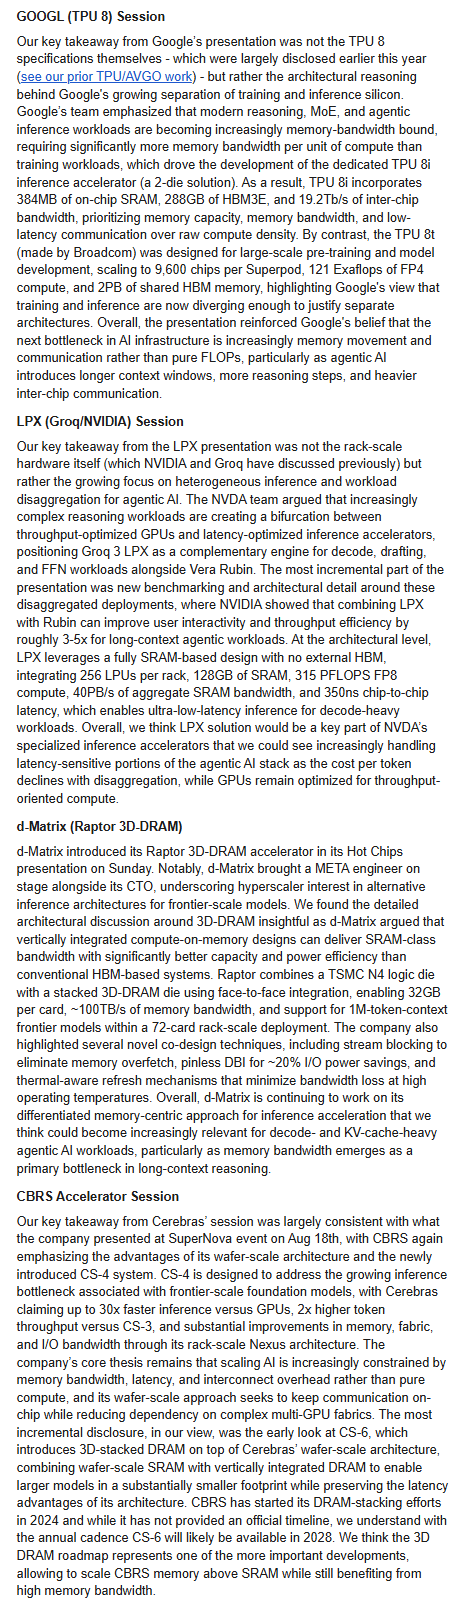
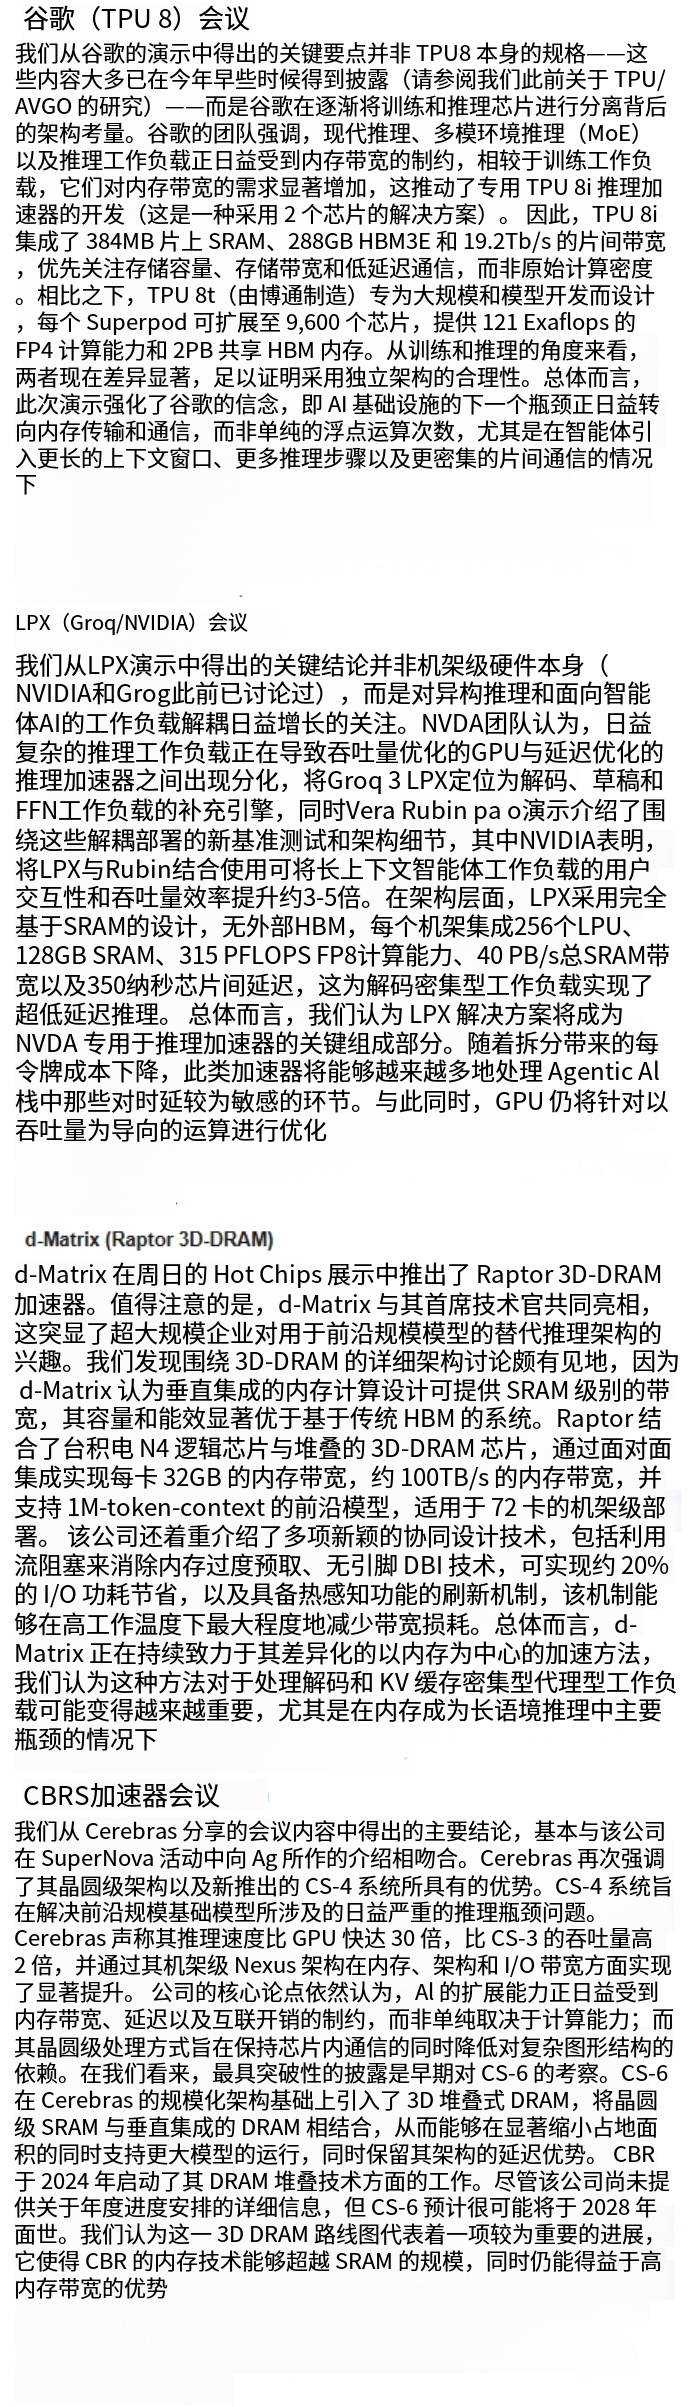
GOOG TPU 8i(推理,2-die)是一款内存带宽芯片:384MB 片上 SRAM、288GB HBM3E、19.2Tb/s 芯片间带宽。之所以构建它,是因为推理 / MoE / 代理式解码现在比训练更受内存限制。
TPU 8t(AVGO,训练):9,600 芯片/超级荚、121 EF FP4、2PB 共享 HBM。不同的产品。训练和推理芯片已分化到足以支持两种架构的程度。
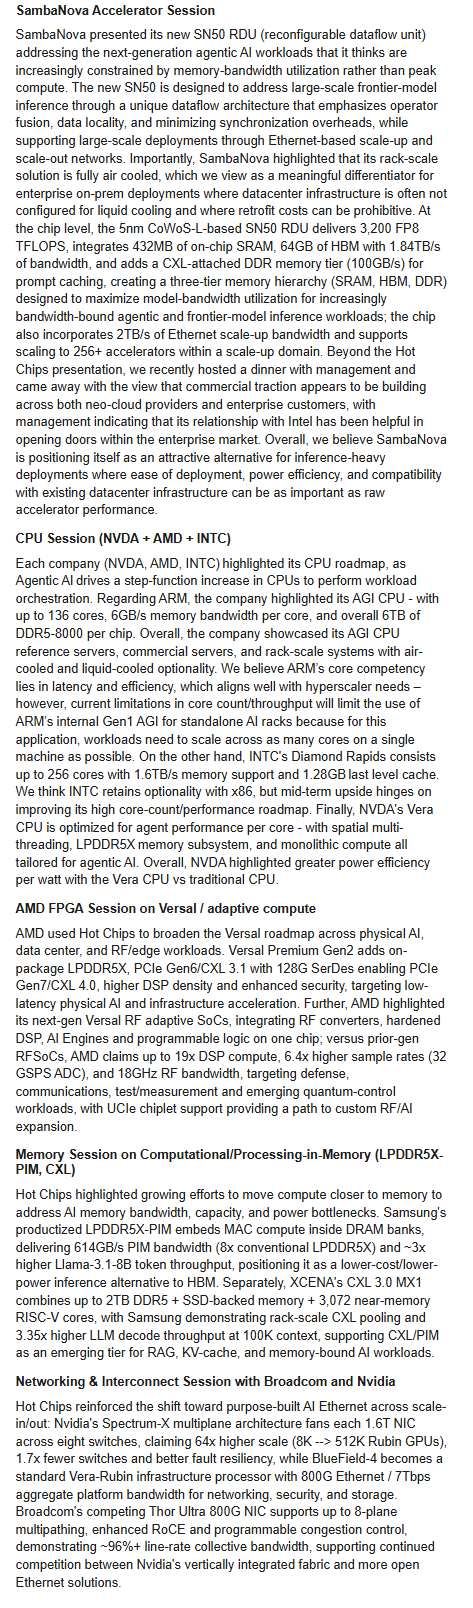
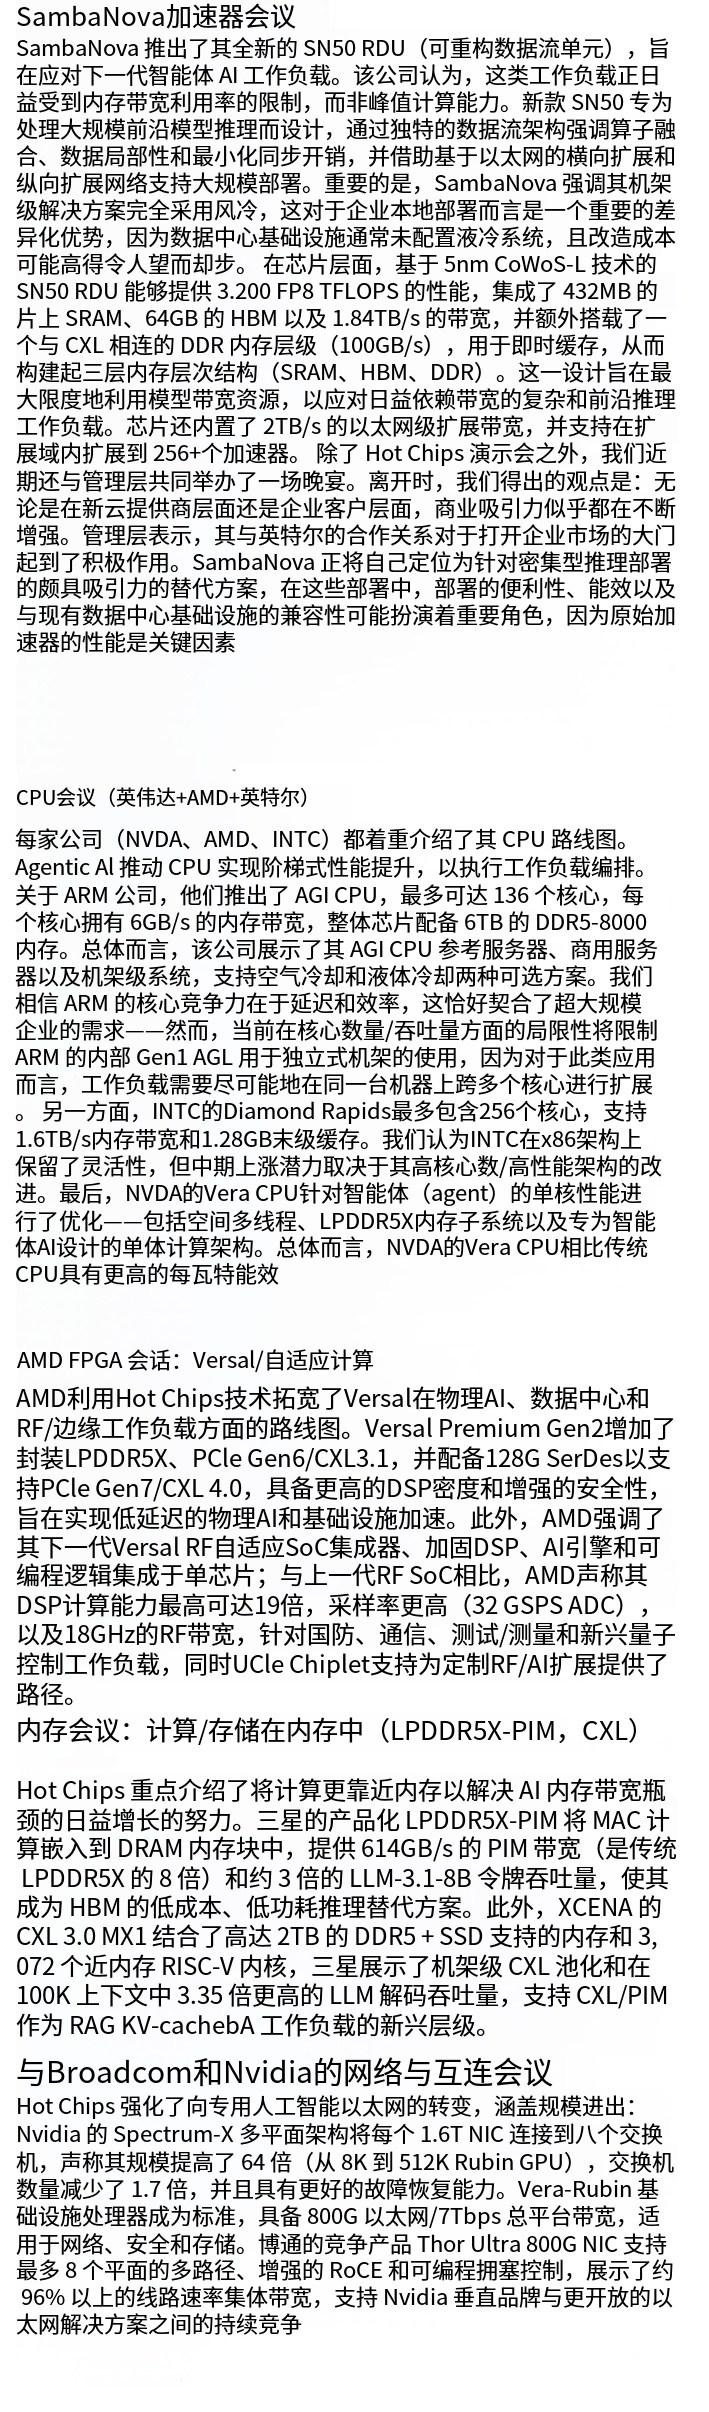
同一场会议,其他地方也存在相同瓶颈:
三星 LPDDR5X-PIM:在 DRAM 存储体内部集成 MAC。614GB/s PIM 带宽(8 倍 LPDDR5X)、约 3 倍 Llama-3.1-8B 令牌。廉价推理 vs HBM。
CXL 池化(三星演示):在 100K 上下文下 LLM 解码提升 3.35 倍。d-Matrix 3D-DRAM:META 工程师登台。32GB/卡、约 100TB/s、在 72 卡机架中支持 1M 令牌上下文。LPX(Groq/$NVDA):完全无 HBM。仅 SRAM 解码。LPX + Rubin 在长上下文代理式任务上提升约 3-5 倍。$CBRS CS-6:晶圆级 SRAM 上的 3D DRAM。约 2028 年。
净结论:TPU 8i 是 Google 在说推理是一个内存移动问题。PIM / CXL / 3D-DRAM / SRAM 解码是其他所有人都在说同样的事情。AVGO 仍然拥有训练超级荚。持续时间取决于两者之下的内存堆栈。
总体总结
主题正文
- GOOG TPU 8i(推理,2-die)是一款内存带宽芯片:384MB 片上 SRAM、288GB HBM3E、19.2Tb/s 芯片间带宽。
- TPU 8t(AVGO,训练):9,600 芯片/超级荚、121 EF FP4、2PB 共享 HBM。
- 三星 LPDDR5X-PIM:在 DRAM 存储体内部集成 MAC。
- 614GB/s PIM 带宽(8 倍 LPDDR5X)、约 3 倍 Llama-3.1-8B 令牌。
- CXL 池化(三星演示):在 100K 上下文下 LLM 解码提升 3.35 倍。
- 32GB/卡、约 100TB/s、在 72 卡机架中支持 1M 令牌上下文。
- 净结论:TPU 8i 是 Google 在说推理是一个内存移动问题。
- PIM / CXL / 3D-DRAM / SRAM 解码是其他所有人都在说同样的事情。